
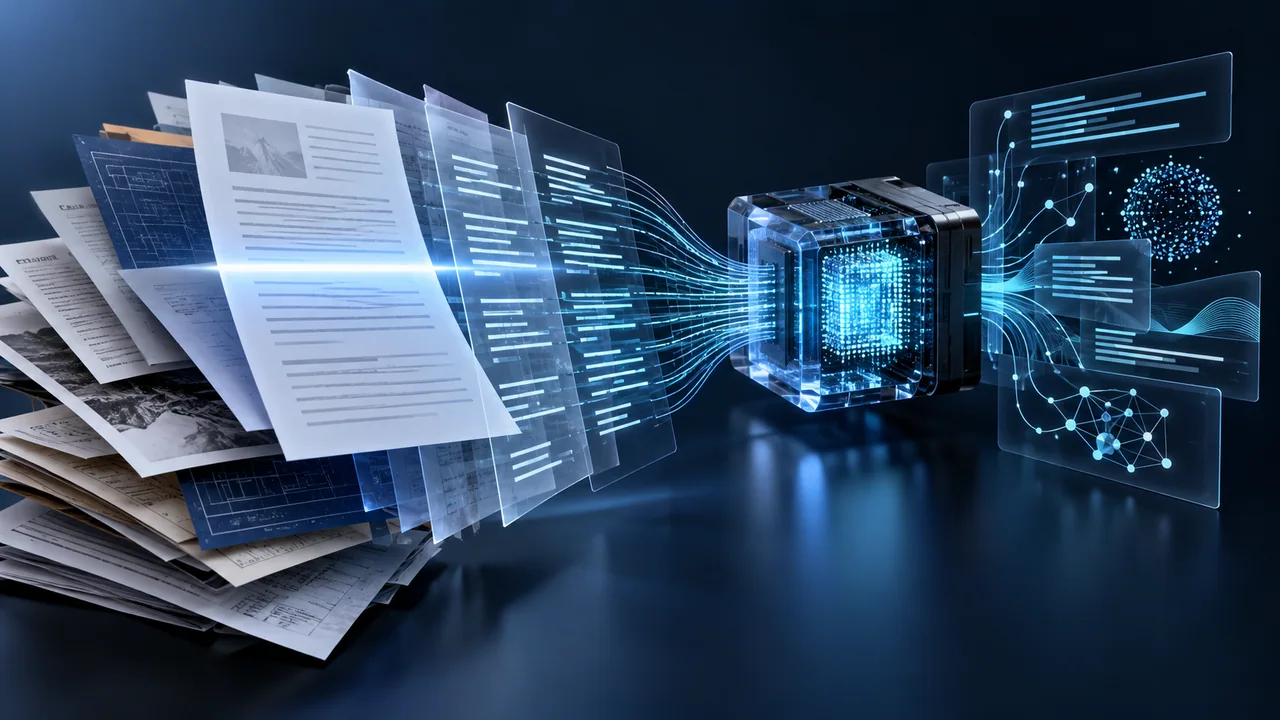
웹·문서 수집
분석 목적에 맞는 공개 웹페이지와 문서를 확보합니다.
비정형 웹페이지와 문서에서 글자를 읽고 텍스트를 분류해 분석 가능한 정보로 바꿉니다.
기업소개서는 웹페이지·문서 OCR, 텍스트 데이터 수집·분석, 자연어 처리 및 유해 콘텐츠 탐지를 핵심 기술로 제시합니다. 분석 결과는 사람이 검토할 수 있는 정보로 제공합니다.
분석 목적에 맞는 공개 웹페이지와 문서를 확보합니다.
이미지 속 글자를 기계가 처리할 수 있는 텍스트로 변환합니다.
텍스트의 주제와 위험 신호를 분류해 검토에 연결합니다.
GET IN TOUCH
도입·기술·실증·연구협력 문의를 남겨 주시면 확인 가능한 범위에서 답변드립니다.